




İnternet ve Nesnelerin İnterneti (sensorler, akıllı cihazlar vb.) gibi yaygın teknolojiler, veri toplama ve veri erişilebilirliğinin boyutunu katlanarak artırmıştır. Bu büyük veri, yalnızca mevcut kurumsal analitik sistemlerin yapısını zorlamakla kalmamakta, aynı zamanda yeni bilgi ve rekabet avantajı yaratmak için yeni fırsatlar sunmaktadır. İşletmeler, büyük veri analitiği yeteneklerini uygulayarak ve işleterek bu fırsatlardan yararlanmaktadır. Facebook, LinkedIn, Twitter gibi sosyal ağ şirketleri ve Netflix gibi video akış şirketleri büyük veri analitiği uygulamış ve ardından ilgili literatürü yayınlamışlardır. Ancak, bu kullanım senaryoları basitleştirilmiş ve tutarlı bir büyük veri analitiği referans mimarisi sunmamıştır ve halen sınırlı sayıda referans mimarisi bulunmaktadır. Bu makale, mevcut dört kullanım senaryosuna dayanarak bir referans mimarisi önererek büyük veri analitiğini basitleştirmeyi amaçlamakta ve ardından bu mimariyi Amazon ve Google analitik hizmetleri ile doğrulamaktadır.
Anahtar Kelimeler: Büyük Veri, Analitik, Referans Mimarisi.
1 Giriş
Bulut bilişim ve Nesnelerin İnterneti teknoljisinin (mobil, sensörler vb. dijital veri toplama cihazları) evrimi, veri toplama ve veri erişilebilirliğinin ölçeğini katlanarak artırmıştır [1; 2]. Dijital teknoloji (sosyal ağ uygulamaları vb.), insanların verilerle etkileşimine olanak tanımakta ve her zamankinden daha fazla veri paylaşılmaktadır [1]. Her sektörde, işletmeler müşterilerini daha iyi anlamak, ürün ve hizmet farklılaşması yaratmak ve aynı zamanda maliyetleri düşürüp verimliliği artırmak için veriyi iş dönüşümünün merkezine koymaya odaklanmaktadır [1; 2; 3]. Sonuç olarak, veri büyük veri ile birlikte temel itici güçlerden biri haline gelmekte ve giderek karmaşıklaşan iş analizleri ve analitiğin merkezinde yer almaktadır [1]. Böylece, veriye dayalı analitik işletmeler için ana akım bir süreç haline gelmiştir [2]. [4] analitiği, “büyük veriden analiz yapmak ve istihbarat elde etmek için kullanılan teknikler” olarak tanımlamıştır. Biz analitiği, “büyük verinin içgörü üretmek amacıyla toplanması, işlenmesi, analizi (makine öğrenmesi modelleri, istatistikler vb.) ve görselleştirilmesi” olarak referans alıyoruz.
Güncel veri analitiği sistemleri büyük veriyi yeterince işleyememekte, ayrıca büyük veriyi işleyen mevcut sistemler esnek olmayan ve karmaşık platformlar, araçlar ve bilgilerden oluşmaktadır. Bunun çok daha merkezi ancak esnek bir analitik altyapıya yeniden yapılandırılması gerekmektedir [1]. Bunun nasıl yapılacağı sorunu, işletmelere ve araştırma topluluğuna bir meydan okuma sunmaktadır. Referans mimariler somut mimarilerin oluşturulmasına yardımcı olabilir [19], ancak halen büyük veri analitiği için yeterli sayıda ve tutarlı bir referans mimarisi bulunmamaktadır.
Bu makalenin amacı, büyük veri analitiği sistemlerini basitleştirmenin gerçekleştirilmesini araştırmak ve ardından yeni bir üst düzey soyut referans mimarisi önermektir. Sistemin mimari tasarımı, temel alınan süreçlerin, teknolojilerin ve hizmetlerin kullanımı gibi temel hususlar ve değerlendirmeler, bir büyük veri analitiği sisteminin gerçekleştirilmesi için önemlidir [5]. Bu çalışmanın katkıları şunlardır: a) Mevcut yayınlara dayalı olarak bir büyük veri analitiği platformu tasarlamak için üst düzey bağımsız bir referans mimarisi sunmak, b) Önerilen referans mimarisini mevcut farklı büyük veri analitiği sistemleri ile doğrulamak.
Makalenin yapısı şu şekildedir: İlgili çalışmalar ve literatür incelemesi Bölüm 2’de sunulmuştur. Referans mimarisinin oluşturulması, büyük veri kullanım senaryoları ve LinkedIn büyük veri kullanım senaryosunun referans mimarisiyle eşleştirilmesi Bölüm 3’te sunulmuştur. Sayfa sınırlaması nedeniyle diğer kullanım senaryolarının tamamı sunulmamıştır. Son olarak, Bölüm 4’te kısa bir sonuç verilmiştir.
2 İlgili Çalışmalar
Bu bölümde, geçmiş yayınlara dayanarak mevcut büyük veri analitiği kullanım senaryoları ve ilgili referans mimarileri incelenmiştir.
Büyük Veri Analitiği Sistemi
Son birkaç yılda, Facebook, Twitter ve LinkedIn gibi sosyal ağ alanından Netflix gibi eğlence video akış şirketine kadar çeşitli büyük ölçekli veriye dayalı analitik sistemler yayınlanmıştır. Ayrıca, sağlık sektörü gibi diğer endüstriler de büyük veri analitiğine olan büyük ilgi ve fırsatlarını tanımış ve göstermiştir. Facebook, LinkedIn ve Twitter, kullanıcılarından akış verileri de dahil olmak üzere veriler toplamaktadır [6; 9; 10; 11; 12]. Facebook ve LinkedIn genellikle web günlükleri gibi geleneksel verilerin yanı sıra akış verileriyle de ilgilenirken, Twitter çoğunlukla akış verileriyle ilgilenmektedir [6; 7; 8; 10; 11; 12]. Toplanan veriler daha sonra toplu veya akış işleme yöntemleriyle kendi özel işlevsellikleriyle yönetilir. Derin Analitik, eğitilmiş modeller ve belirlenmiş işler, Hadoop HDFS ile algoritma hizmeti gibi çeşitli veri analizi ve toplulaştırmaları, büyük ölçüde kümeleme ve dağıtık hesaplamalarda uygulanmaktadır. Ayrıca, Netflix kullanıcı etkinliklerini toplamakta ve bunları Çevrimiçi, Yakın Çevrimiçi ve Çevrimdışı hesaplamalarda işlemektedir [13; 14]. Çevrimiçi veri analizi ile işlenen öneriler kullanıcılara sunulmaktadır.
Büyük Veri Analitiği Sistemleri için Referans Mimari
Hizmet odaklı mimari ve ilkeleri, kurumsal yazılım alanında yazılım tasarımı, mimarisi ve uygulamasını kolaylaştırmaktadır [16, 17]. Ayrıca, çeşitli referans mimarileri yayınlanmıştır. Gaister ve Avgeriou [18], adım adım bir sürece dayalı bir yazılım referans mimarisi önermiştir. Altı adım içerir; referans mimarisi için bir tip belirleme, tasarım stratejisi seçimi, verilerin ampirik olarak elde edilmesi, referans mimarisinin inşası, değişkenliğin sağlanması ve değerlendirme. Angelov, Grefen ve Greefhorst [19] yazılım referans mimarilerini sunmuş ve bunun daha iyi mimari tasarımı kolaylaştırdığını ve dolayısıyla daha iyi başarıya yol açacağını iddia etmiştir. Çok boyutlu bir sınıflandırma alanı ve beş tip referans mimarisinden oluşan bir yazılım referans mimarileri için çerçeve sunmuşlardır.
Büyük veri bağlamında sınırlı sayıda mimari önerilmiştir. Paakkonen ve Pakkala [5], yayınlanmış büyük veri kullanım senaryoları ve ilişkili ticari ürünlere dayalı olarak bir referans mimarisi ve teknolojilerin, ürünlerin ve hizmetlerin sınıflandırmasını sunmuştur. [20] tarafından bir büyük veri mimarisi çerçevesi için büyük veri yaşam döngüsü ve altyapısının üst düzey bir tanımı sunulmuştur. Schmidt ve Mohring [21], bulut alanında büyük veri işlem hattı uygulamak için bir hizmet ve dağıtım modeli önermiştir. Kurumsal veri trafiğindeki farklı büyüme modellerini desteklemek için SQL ve NewSQL veritabanlarının entegrasyonu için referans mimarileri önerilmiştir [22]. Ayrıca, bellek içi depolama sistemi ve dağıtık görev yürütme analizi için bir büyük veri mimarisi önerilmiş ve doğrulanmıştır [23]. Büyük veri yönetimini veri üretiminden ve anlamsal tüketimden ayıran başka bir katmanlı mimari (SOLID) de önerilmiştir [24]. Tahmine dayalı ve gerçek zamanlı analitik için, yapılandırılmış tarihsel ve zamansal veriler için genelleştirilmiş bir yazılım mimarisi önerilmiştir [25].
Literatür incelemesi, büyük veri analitiği bağlamında sınırlı sayıda referans mimarisi olduğunu ve somut veya tutarlı bir referans mimarisinin eksikliğini göstermektedir. Bu durum, büyük veri analitiği için referans mimarisi konusunda daha fazla araştırma ihtiyacını ortaya koymaktadır.
3 Büyük Veri Analitiği için Referans Mimari
Referans mimarisi, somut mimarilerin oluşturulmasına ve ayrıca bir büyük veri analitiği sistemindeki tipik ilgili işlevsellik ve veri akışlarının genel mimarisinin anlaşılmasına yardımcı olabilir [19]. Bir referans mimarisi aynı zamanda mevcut büyük veri sistemlerini analiz etmek, veri analizi süreçlerinin ve teknolojilerinin sınıflandırılmasının temelini sağlamak için de kullanışlıdır. Süreçleri, teknolojileri ve hizmetleri gruplara (bileşenlere) ayırmak, sistem süreçleri ve işlevlerinin gerçekleştirilmesi ile ilgili karar vermeyi daha da kolaylaştırır.
Tablo 1’de gösterilen büyük veri analitiği kullanım senaryolarının karşılaştırılmasında, büyük veri kullanımının temel unsurlarını beş bileşene ayırdık: Veri Kaynağı; Veri Entegrasyonu; Veri Analizi ve Toplulaştırma; Arayüz ve Görselleştirme; ve İş ve Model Belirtimi.
| Büyük Veri Analitiği Kullanım Senaryosu | Veri Kaynağı | Veri Entegrasyonu | Veri Analizi, Toplama | Model, İş Arayüzü, Görselleştirme |
|---|
| MySQL, Web Sunucu Logları | Veritabanı dökümü kopyası, Scribe, Hadoop ham veri, Replikasyon | Küp, Derin Analiz, Hive işleri | İşler veritabanında saklanır, Microstrategy görselleştirme ve kullanıcı uygulamaları |
| Oracle, Kullanıcı Aktivite Verisi | Oracle (Snapshot), Kafka, Hadoop, Veri temizleme, Tekilleştirme, Replikasyon | Derin Analiz, Hive, Pig, MR, Voldemort, Avatara | Azkaban Çerçevesi, Görselleştirme uygulamaları (kurumsal), LinkedIn kullanıcıları |
| Firehose (tweetler), Updater, Sorgular | Tokenizasyon, İstatistiksel sorgular, Firehose’un filtrelenmesi ve kişiselleştirilmesi, Sıralama | Hadoop HDFS (sıralama algoritması, analiz), Önbellek veritabanı | Sıralama algoritması, Twitter kullanıcıları |
| Netflix | Akış verisi (Kullanıcılar ve çevrimiçi servis) | Chukwa, Akış sinyalleri, Manhattan Çerçevesi | Derin Analiz: Çevrimdışı/Çevrimiçi, Yakın gerçek zamanlı | Algoritmalar, Makine Öğrenmesi, Pig, Netflix kullanıcıları, Görselleştirme uygulamaları (kurumsal) |
-
a. Veri Kaynağı: Toplanacak verilerin orijinal kaynağını ifade eder. Veriler ilişkisel veri veya NoSQL gibi geleneksel veritabanlarında saklanabilir. Veriler yapılandırılmış, yapılandırılmamış, yarı yapılandırılmış veya akış verisi olabilir.
-
b. Veri Entegrasyonu: Verinin Toplanması, İşlenmesi ve Yüklenmesini içerir. Toplama, verileri (birden fazla) kaynaktan depolama veya analiz için alma işlemidir. Anlık Görüntü gibi bunun için çeşitli teknikler vardır. Veri İşleme, kaynak verilerin Yükleme aşamasına geçmeden önce işlenmesi için gereken yürütmeleri kapsar. Veri İşleme, veri temizleme, çoğaltma, filtreleme, algoritma hizmeti gibi işlevselliği temsil eder. Daha sonra Veri Yükleme yürütülebilir, yani toplanan ve işlenen veriler artık Hadoop HDFS gibi bir veri deposuna yüklenir. Üç öğeyi (Veri Toplama, İşleme ve Yükleme) bir bileşende grupladık çünkü her bir öğe birbirine yakından bağlıdır. Örneğin, veri toplama, verileri temizleme veya biçimlendirme ve ayrıca verileri bir depoya yükleme için veri işleme gerektirir. Üst düzey mimaride, bunun birbirine yakından ilişkili öğeler arasındaki mantıksal bağlantıyı ve akışı iyileştirdiğine ve dolayısıyla daha net ve etkili bir genel mimari sağladığına inanıyoruz.
-
c. Veri Analizi ve Toplulaştırma: Veri analizi, ilgili veri analizi görevlerini ve süreçlerini ifade ederken, Toplulaştırma, analiz sonuçlarını saklayan veri depolamayı (çok boyutlu dahil) ifade eder.
-
d. Arayüz ve Görselleştirme: Son kullanıcıları (yani geçici analiz, sorgular vb.) ve ayrıca dashboard’lar gibi görselleştirme tabanlı uygulamaları temsil eder.
-
e. Model ve İş Belirtimi: Bu, makine öğrenmesi, eğitilmiş modeller, işlerin belirtimleri ve zamanlaması ile bunların depolama alanlarını kapsar.
Ayrıca, büyük veri kullanımlarını modellemek için kendi eşleme notasyonlarımızı (veri akışı, entegrasyon, işleme, analiz ve arayüze dayalı) geliştirdik. Birincil niyetimiz, bir büyük veri sistemini basitleştirmek ve genel mimarisini etkili bir şekilde anlamaktı. Ek olarak, büyük veri analitiği literatür ve kullanım senaryoları üzerine yaptığımız çalışma, eşleme notasyonlarında iyileştirme ihtiyacı olduğunu ortaya çıkardı. Böylece, Tablo 2’de sunulan kendi eşleme notasyonlarımızı oluşturduk ve ardından Şekil 1’de sunulan bir referans mimarisi ürettik.
Notasyon 1, 2 ve 3 ‘veri kaynağı’, ‘veri entegrasyonu’, ‘veri analizi ve toplulaştırma’, ‘iş modeli belirtimi’nde bulunur. Notasyon 4 ve 5 ‘arayüz ve görselleştirme’de kullanılır. Notasyon 6 ve 7 ‘iş ve model belirtimi’nde kullanılır. Ve Notasyon 8 ve 9, Notasyon 1-7’nin elemanları arasındaki bağlantılardır.
LinkedIn Örneğinin Eşleştirilmesi
LinkedIn’de, kullanıcı etkinlik verileri toplanır ve veritabanı anlık görüntüleri ile aktarılır. Etkinlik verileri, LinkedIn hizmetlerinin kullanımını ifade eder ve akış etkinlikleri olarak ele alınır. Dağıtılmış bir yayınlama/abonelik mesajlaşma sistemi olan Kafka, akış etkinliklerinin toplanması için kullanılır [7].
Kafka ile üreticiler, olayları bir brokere raporlar ve tüketiciler verileri kendi hızlarında okur [7]. Kafka’nın etkinlik verileri, birleştirme, yineleme kaldırma gibi daha fazla işleme görevleri için Hadoop ETL kümesine taşınır. Hadoop ETL kümesindeki veriler, üretim ve geliştirme kümelerine kopyalanır.
İş yükleri tipik olarak şu şekilde gerçekleştirilir; ilk deneyler Geliştirme kümesinde yürütülür ve ardından başarılı inceleme ve testin ardından üretim kümesine aktarılır. Üretim kümesinden gelen analiz sonuçları hem çevrimdışı (hata ayıklama) hem de çevrimiçi veritabanında saklanır. Ayrıca, bu sonuçlar Kafka kümesinde tekrar kullanılabilir [7].
Azkaban, çeşitli iş türlerini desteklemesi nedeniyle iş yüklerinin zamanlanması için kullanılır. Azkaban, Hadoop işlerini yürütmek için LinkedIn’de oluşturulmuş bir toplu iş akışı zamanlayıcısıdır. Her Hadoop ortamında bir Azkaban örneği çalıştırılır. Zamanlanmış Azkaban iş yükleri MapReduce, Pig, kabuk betiği veya Hive işleri olabilir. LinkedIn’de oluşturulan ölçeklenebilir ve hızlı bir OLAP sunum sistemi olan Avatara, verileri analiz etmek ve işlemek için kullanılır ve ardından bu veriler Voldemort veritabanlarında saklanır [8].
LinkedIn büyük veri analitiğini, ürettiğimiz referans mimarisiyle eşleştirdik ve bu eşleme Şekil 2’de sunulmuştur.
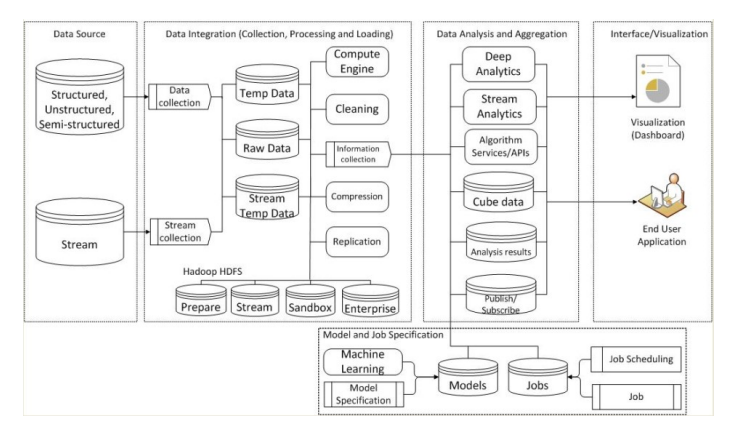

Şekil 1: Büyük Veri Analitiği Referans Mimarisi
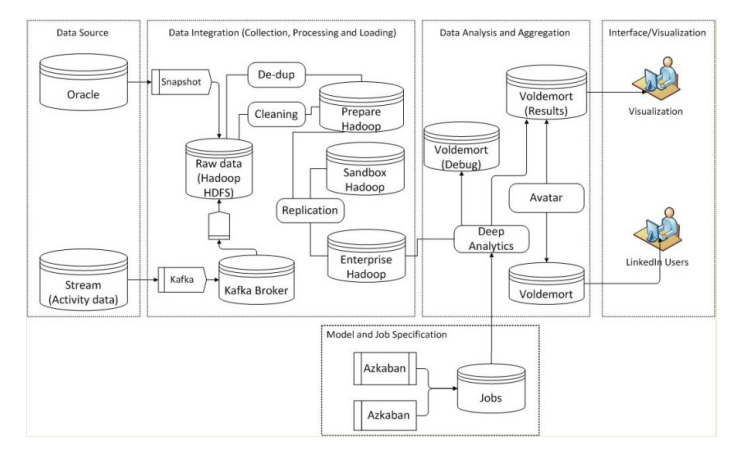
Şekil 2: LinkedIn Büyük Veri Analitiği Referans Mimarisinin Eşleştirilmesi

4 Sonuç
Amacımız büyük veri analitiği sistemlerini basitleştirmekti, bu nedenle Facebook, LinkedIn, Twitter ve Netflix’teki büyük veri kullanım senaryolarını araştırdık ve karşılaştırdık ve ardından bir büyük veri analitiği sistemini basitleştirmek ve genel mimarisini etkili bir şekilde anlamak için kendi eşleme notasyonlarımızla bir referans mimarisi oluşturduk. Karşılaştırma tablomuz Tablo 1’de bulunabilir ve referans mimarimiz Şekil 1’de sunulmuştur. Ayrıca, LinkedIn Kullanım Senaryosu Referans Mimarisini eşleştirdik ve ürettik, bu da Şekil 2’de sunulmuştur. Sayfa sınırlaması nedeniyle diğer kullanım senaryoları üzerindeki çalışmalarımızı sunmadık. Ürettiğimiz eşlemelere dayanarak, referans mimarisinin bu geniş yelpazedeki durumları kapsayabildiği ve tutarlı bir sonuç ürettiği açıktır. Mimarinin endüstriyel uygulaması ve değerlendirilmesi, ek anlayış ve geçerlilik sağlayacaktır.
Teşekkür. Bu araştırma kısmen EU H2020 FIRST projesi, Hibe No. 734599 tarafından desteklenmiştir.