



Giriş: Büyük Veri’nin Yükselişi ve Düşüşü
On yılı aşkın bir süredir insanların verilerinden işe yarar içgörüler elde edememesinin sebebi, çoğunlukla verinin büyüklüğüne bağlandı. Teşhis şuydu:
“Veriniz, sistemleriniz için fazla büyük.”
Çözüm olarak ise bu devasa ölçeği kaldırabilecek yeni, pahalı teknolojiler satın almaları söylendi.
Ama büyük veri ekipleri tüm bu yeni araçları alıp eski sistemlerden göç ettikten sonra bile insanlar verilerini anlamlandırmakta zorlanmaya devam etti. Dikkat edenler için sorun hiçbir zaman veri boyutu değildi.
2023’te dünya, büyük veri alarmının ilk çaldığı zamandan farklı görünüyor. Beklenen veri felaketi gerçekleşmedi. Veri boyutları biraz artmış olabilir ama donanımlar çok daha hızlı büyüdü. Satıcılar hâlâ ölçeklenebilirlik vaat ediyor, fakat kullanıcılar bunun gerçek dünyadaki sorunlarıyla ne kadar ilişkili olduğunu sorgulamaya başladı.
On yıldan uzun bir süredir, insanların verilerinden işe yarar içgörüler elde etmekte zorlanması, verinin büyüklüğüne bağlandı. Teşhis, “Veriniz, sizin cılız sistemleriniz için çok büyük” oldu ve reçete de devasa ölçeği idare edebilen yeni, süslü bir teknoloji satın almaktı. Tabii ki, Büyük Veri görev gücü tüm yeni araçları satın alıp Eski Sistemlerden (Legacy) geçiş yaptıktan sonra, insanlar verilerini anlamlandırmakta hâlâ zorlandıklarını fark ettiler. Gerçekten dikkat edenler, aslında sorunun veri büyüklüğü olmadığını da fark etmiş olabilirler.
2023’te dünya, Büyük Veri alarm zillerinin çalmaya başladığı zamandan çok farklı görünüyor. Öngörülen veri kıyameti gerçekleşmedi. Veri boyutları biraz daha büyümüş olabilir, ancak donanım çok daha hızlı bir oranda büyüdü. Satıcılar hâlâ ölçeklenebilirlik yeteneklerini pazarlıyor, ancak uygulayıcılar bunun kendi gerçek dünya problemleriyle nasıl bir ilişkisi olduğunu merak etmeye başlıyor.
Bu Yazının Amacı
Bu yazı, Büyük Veri çağının sona erdiği tezini savunacak. İyi bir koşuşturması oldu, ancak artık veri boyutu için endişelenmeyi bırakıp onu daha iyi kararlar vermek için nasıl kullanacağımıza odaklanabiliriz.
Zorunlu Giriş Slaydı
Son 10 yıldır, her büyük veri ürünü için her pitch deck (yatırımcı sunumu), şuna benzeyen bir slaytla başlar: Zaman içinde üretilen veri artıyor.
Bu slaydın mesajı, eski veri işleme yöntemlerinin işe yaramayacağıydı. Veri üretimindeki hızlanma, eski veri sistemlerini çamurda saplanmış halde bırakacak ve yeni fikirleri benimseyenler rakiplerini sollayabilecekti.
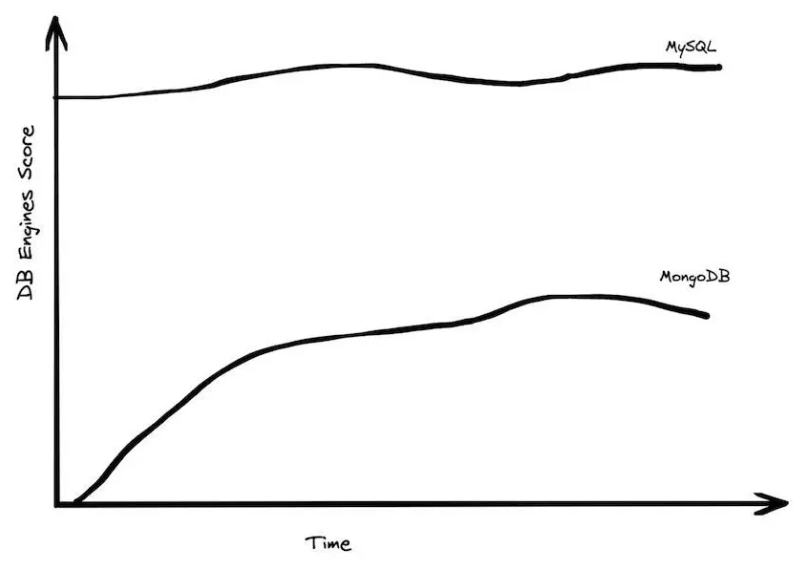
Tabii ki, üretilen veri miktarı artsa bile bu herkes için bir problem olduğu anlamına gelmez; veri eşit dağılmaz. Çoğu uygulama devasa miktarda veriyi işlemeye ihtiyaç duymaz. Bu, geleneksel mimarilere sahip veri yönetimi sistemlerinde bir canlanmaya yol açtı; SQLite, Postgres, MySQL güçlü bir şekilde büyürken, “NoSQL” ve hatta “NewSQL” sistemleri durgunlaşıyor.
Çoğu İnsanın O Kadar Çok Verisi Yok
“Büyük Veri geliyor” grafiğinden çıkarılması beklenen mesaj, çok yakında herkesin verisiyle boğulacağıydı. On yıl sonra, o gelecek gerçekleşmedi. Bunu birkaç yolla doğrulayabiliriz: verilere bakarak (niceliksel), insanlara deneyimleriyle tutarlı olup olmadığını sorarak (niteliksel) ve ilk prensiplerden düşünerek (tümevarımsal).
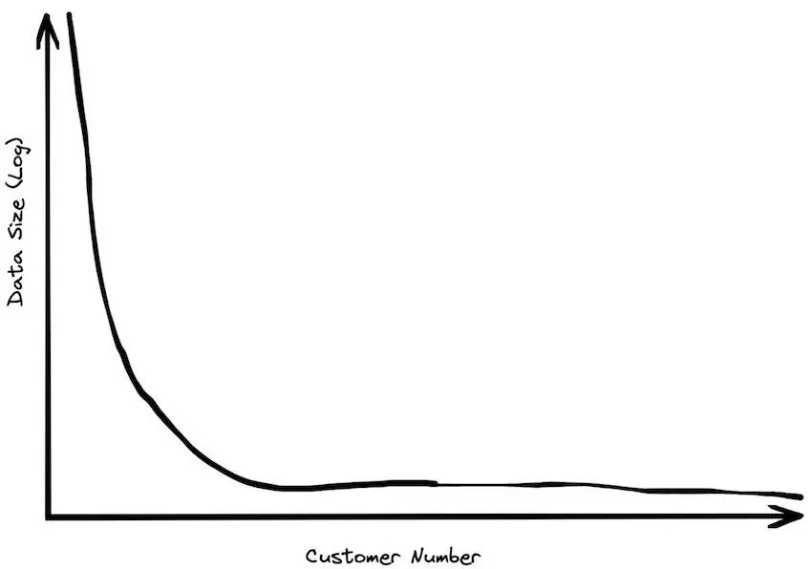
BigQuery’de çalışırken müşteri boyutlandırmalarına çok zaman harcadım. Müşterilerin büyük çoğunluğunun toplam veri depolamasında bir terabayttan az verisi vardı. Elbette çok büyük miktarda veriye sahip müşteriler de vardı, ancak çoğu kuruluşun, hatta oldukça büyük bazı şirketlerin bile orta düzeyde veri boyutları vardı.
Müşteri veri boyutları bir güç yasası dağılımı izliyordu. En büyük müşteri, bir sonraki en büyük müşterinin iki katı depolama alanına sahipti, bir sonraki en büyük müşteri onun yarısına sahipti, vb. Yani yüzlerce petabayt veriye sahip müşteriler olsa da, boyutlar çok hızlı bir şekilde azalıyordu.
Sektör analistleriyle (Gartner, Forrester, vb.) konuşurken da bunu destekleyen şeyler bulduk. Devasa veri kümelerini işleme yeteneğimizi överdik, onlar da omuz silkerlerdi. “Bu güzel,” derlerdi, “ancak şirketlerin büyük çoğunluğunun bir terabayttan küçük veri ambarları var.”
Büyük veri boyutlarının neden nadir olduğunu anlamak için, verinin aslında nereden geldiğini düşünmek faydalıdır. Orta ölçekli bir işletme olduğunuzu ve bin müşteriniz olduğunu hayal edin. Diyelim ki her bir müşteriniz her gün yüz satır öğesi olan yeni bir sipariş veriyor. Bu nispeten sık gerçekleşen bir durum, ancak yine de günde bir megabayttan az veri üretiliyor. Üç yılda yalnızca bir gigabaytınız olur ve bir terabayt üretmek binlerce yıl alır.
Somut bir örnek vermek gerekirse, 2020-2022 yıllarında, hızlı büyüyen, önemli geliri ve unicorn değerlemesi olan bir Series E şirketi olan SingleStore’da çalıştım. Finans veri ambarımızın, müşteri verilerimizin, pazarlama kampanya takibimizin ve servis log’larımızın boyutunu toplasaydınız, muhtemelen sadece birkaç gigabayt ederdi. Bu, hiçbir şekilde büyük veri değildir.
Depolama ve İşlemin Ayrılmasındaki Depolama Önyargısı
Modern bulut veri platformlarının tümü depolama ve işlemi ayırır, bu da müşterilerin tek bir forma bağlı olmadığı anlamına gelir. Bu, ölçeklenmeden çok, son 20 yıldaki veri mimarilerindeki en önemli değişikliktir.
Pratikte, veri boyutları işlem boyutlarından çok daha hızlı artar. Depolama ve işlem ayrımının faydalarını anlatan popüler açıklamalar, her ikisini de istediğiniz zaman ölçeklendirebileceğiniz gibi gelse de, bu iki eksen aslında eşdeğer değildir. Büyük işlem gereksinimleriyle başa çıkma teknikleri, büyük verilerle başa çıkmaktan farklıdır.
Tüm büyük veri kümeleri zaman içinde üretilir. Zaman neredeyse her zaman bir veri kümesinde bir eksendir. İş statikse, ne büyüyorsa ne de küçülüyorsa, veri zamanla doğrusal olarak artacaktır. Bu, analitik ihtiyaçlar için ne anlama gelir? Açıkçası, veriyi budamaya karar vermediğiniz sürece (buna daha sonra değineceğiz) depolama ihtiyaçları doğrusal olarak artacaktır. Ancak işlem ihtiyaçları zaman içinde pek değişmeyecektir; çoğu analiz güncel veriler üzerinden yapılır. Eski verileri taramak oldukça maliyetlidir; değişmezler, peki neden defalarca okumaya para harcayasınız? Elbette, veriye yeni bir soru sormak isterseniz diye saklamak isteyebilirsiniz, ancak önemli cevapları içeren özetler (aggregations) oluşturmak oldukça önemsizdir.
Çoğu zaman, bir veri ambarı müşterisi, depolama ve işlem ayrımının olmadığı bir ortamdan, ayrımın olduğu bir ortama taşındığında, depolama kullanımları muazzam şekilde büyür, ancak işlem ihtiyaçları pek değişmez.
Depolama boyutundaki bu işlem boyutuna göre öncelik, sistem mimarisinde gerçek bir etkiye sahiptir. Ölçeklenebilir nesne depoları kullanırsanız, öngördüğünüzden çok daha az işlem gücü kullanabilirsiniz. Dağıtık işlemi hiç kullanmanıza gerek kalmayabilir.
İş Yükü Boyutları, Toplam Veri Boyutlarından Daha Küçüktür
Analitik iş yükleri için işlenen veri miktarı neredeyse kesinlikle düşündüğünüzden daha küçüktür. Örneğin, dashboard’lar çoğu zaman özetlenmiş verilerden oluşturulur. İnsanlar son bir saate, son bir güne veya son bir haftaya ait verilere bakarlar. Daha küçük tablolar daha sık sorgulanma eğilimindedir, devasa tablolar ise daha seçici olarak.
Birkaç yıl önce BigQuery sorgularını, yılda 1000 dolardan fazla harcayan müşterilere bakarak analiz ettim. Sorguların %90’ı 100 MB’tan az veri işliyordu. Bunu, sonuçları çarpıtan birkaç müşterinin çok sayıda sorgu çalıştırması olmadığından emin olmak için birkaç farklı şekilde dilimledim.
Devasa veri boyutlarına sahip müşteriler, neredeyse hiçbir zaman büyük miktarda veri sorgulamadı. Orta boyutlu verilere sahip müşteriler genellikle oldukça büyük sorgular yaparken, devasa veri boyutlarına sahip müşteriler neredeyse hiç büyük miktarda veri sorgulamadı. Sorguladıklarında da, genellikle bir rapor oluşturuyorlardı ve performans gerçekten bir öncelik değildi.
Devasa tabloları sorgularken bile, çok fazla veri işlemeye nadiren ihtiyaç duyarsınız. Modern analitik veritabanları, yalnızca bir alt küme alan okumak için sütun projeksiyonu (column projection) ve yalnızca dar bir tarih aralığı okumak için bölüm budama (partition pruning) yapabilir. Kümeleme (clustering) veya otomatik mikro bölümleme (automatic micro partitioning) yoluyla verideki yerelliği (locality) kullanan segment eleme (segment elimination) ile daha da ileri gidebilirler. Sıkıştırılmış veri üzerinde hesaplama, projeksiyon ve koşul itme (predicate pushdown) gibi diğer püf noktaları, sorgu zamanında daha az G/Ç (IO) yapmanın yollarıdır. Daha az G/Ç, yapılması gereken daha az hesaplamaya, bu da daha düşük maliyet ve gecikmeye dönüşür.
İşledikleri veri miktarını azaltmaları için insanları teşvik eden akut ekonomik baskılar vardır. Ölçeklenip bir şeyi çok hızlı işleyebilmeniz, bunu ucuza yapabileceğiniz anlamına gelmez. Bir sonuç almak için bin düğüm kullanırsanız, bu muhtemelen size bir kol ve bir bacak kadar pahalıya mal olacaktır. Sahne de BigQuery’i göstermek için çalıştırdığım Petabayt sorgusu, perakende fiyatlarıyla 5.000 dolara mal oluyordu. Çok az kişi bu kadar pahalı bir şeyi çalıştırmak ister.
Çoğu Veri Nadiren Sorgulanır
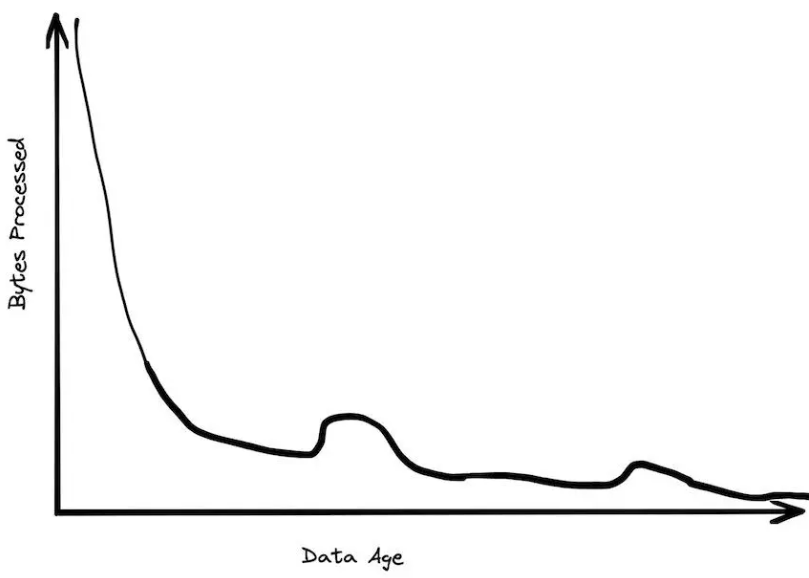
İşlenen verilerin büyük bir yüzdesi 24 saatten daha yenidir. Veri bir haftalık olduğunda, sorgulanma olasılığı muhtemelen en son güne göre 20 kat daha azdır. Bir aydan sonra, veriler çoğunlukla orada öylece durur. Tarihsel veriler nadiren sorgulanma eğilimindedir, belki biri nadir bir rapor çalıştırırken.
Verinin etkin olmaması (quiescing), veri çalışma seti boyutlarının beklediğinizden daha yönetilebilir olduğu anlamına gelir. 10 yıllık veri içeren bir petabaytlık bir tablonuz varsa, mevcut günden daha eski verilere nadiren erişirsiniz; bu da sıkıştırılmış halde 50 GB’tan az olabilir.
Büyük Veri Sınırı Sürekli Geri Çekiliyor
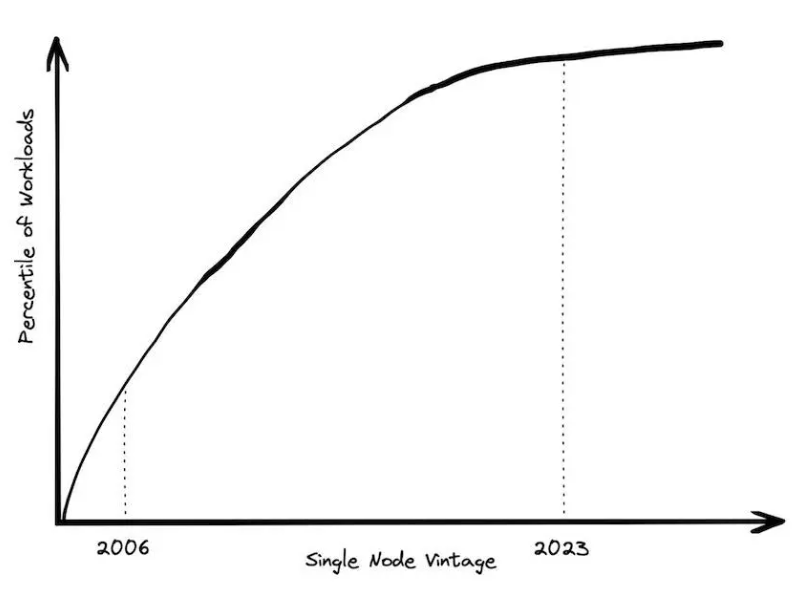
“Büyük Veri”nin bir tanımı, “tek bir makineye sığmayan her şey”dir. Bu tanıma göre, nitelikli iş yükü sayısı her yıl azalmaktadır.
2004’te, Google MapReduce makalesi yazıldığında, bir veri iş yükünün tek bir ticari makineye sığmaması çok yaygın olurdu. Yukarı ölçeklenme (scaling up) pahalıydı. 2006’da AWS EC2’yi başlattığında, alabileceğiniz tek örnek boyutu tek çekirdek ve 2 GB RAM’di. O makineye sığmayacak çok sayıda iş yükü vardı.
Ancak bugün, AWS’de standart bir örnek, 64 çekirdek ve 256 GB RAM ile fiziksel bir sunucu kullanır. Bu iki kat daha fazla RAM. Biraz daha fazla ödemeye razıysanız, bellek için optimize edilmiş bir örnek için iki kat daha fazla RAM alabilirsiniz. Kaç iş yükü 24TB RAM veya 445 CPU çekirdeğinden fazlasına ihtiyaç duyar?
Eskiden daha büyük makineler çok daha pahalıydı. Ancak bulutta, bir sunucunun tamamını kullanan bir VM, sunucunun 8’de 1’ini kullanan bir VM’den yalnızca 8 kat daha pahalıdır. Maliyet, çok büyük boyutlara kadar işlem gücüyle doğrusal olarak ölçeklenir. Aslında, orijinal dremel makalesinde yayınlanan kıyaslamalara bakarsanız, 3.000 paralel düğüm kullanarak, bugün tek bir düğümde benzer performans alabilirsiniz.
Veri Bir Yükümlülüktür (Liability)
Büyük Veri’nin alternatif bir tanımı, “veriyi saklamanın maliyetinin, neyi atacağınıza karar vermenin maliyetinden az olduğu zaman”dır. Bu tanımı seviyorum çünkü insanların neden Büyük Veri ile sonuçlandığını özetliyor. İhtiyaçları olduğu için değil, sadece silmekle uğraşmadıkları için. Birçok veri gölünün (data lake) bu tanıma tamamen uyduğunu düşünün: devasa, dağınık bataklıklar; kimse ne içerdiklerini veya onları temizlemenin güvenli olup olmadığını bilmiyor.
Veriyi saklamanın maliyeti, yalnızca fiziksel baytları depolama maliyetinden daha yüksektir. GDPR ve CCPA gibi düzenlemeler altında, belirli türdeki verilerin tüm kullanımını takip etmek zorundasınız. Bazı verilerin belirli bir süre içinde silinmesi gerekir. Veri gölünüzde bir yerde çok uzun süre duran bir parquet dosyasında telefon numaralarınız varsa, yasal gereksinimleri ihlal ediyor olabilirsiniz.
Düzenlemenin ötesinde, veri, aleyhinize açılan davalara yardımcı olabilir. Tıpkı birçok kuruluşun olası yükümlülüğü azaltmak için sınırlı e-posta saklama politikaları uyguladığı gibi, veri ambarınızdaki veriler de aleyhinize kullanılabilir. Kodunuzda bir güvenlik hatası veya kaçırılmış SLA (Hizmet Seviyesi Sözleşmesi) olduğunu gösteren beş yıl öncesinden log’larınız varsa, eski verileri saklamak yasal maruziyetinizi uzatabilir.
Kod, aktif olarak korunmadığında genellikle insanların “bit çürümesi” (bit rot) dediği şeyden mustarip olur. Veri de aynı tür bir sorundan muzdarip olabilir; yani, insanlar özel alanların tam anlamını unutur veya geçmişten gelen veri problemleri hafızalardan silinmiş olabilir.
Eski verileri saklıyorsanız, neden sakladığınızı anlamak iyidir. Aynı soruları tekrar tekrar mı soruyorsunuz? Öyleyse, sadece özetleri (aggregates) saklamak depolama ve sorgu maliyetleri açısından çok daha az maliyetli olmaz mı? Yağmurlu bir gün için mi saklıyorsunuz? Sorabileceğiniz yeni sorular olabileceğini mi düşünüyorsunuz? Öyleyse, ne kadar önemli? Gerçekten ihtiyacınız olma ihtimali nedir? Gerçekten sadece bir veri biriktirici misiniz? Tüm bu sorular, özellikle de veriyi saklamanın gerçek maliyetini bulmaya çalışırken sorulması önemli sorulardır.
Siz Büyük Veri Yüzde Birlik Diliminde misiniz?
Büyük Veri gerçektir, ancak çoğu insanın endişelenmesine gerek olmayabilir. “Büyük Veri Yüzde Birlik Dilimi”nde olup olmadığınızı anlamak için kendinize sorabileceğiniz bazı sorular:
-
Gerçekten çok büyük miktarda veri mi üretiyorsunuz?
-
Eğer öyleyse, gerçekten bir seferde çok büyük miktarda veri kullanmanız gerekiyor mu?
-
Eğer öyleyse, veri gerçekten tek bir makineye sığamayacak kadar büyük mü?
-
Eğer öyleyse, sadece bir veri biriktirici olmadığınızdan emin misiniz?
-
Eğer öyleyse, özetlemenin daha iyi olmayacağından emin misiniz?
Bu sorulardan herhangi birine hayır yanıtı veriyorsanız, sizi bir gün sahip olabileceğinizi düşündürmeye çalıştıkları boyutta değil, gerçekte sahip olduğunuz boyuttaki verileri yönetmenize yardımcı olacak yeni nesil veri araçları için iyi bir aday olabilirsiniz.
Özet:
“Büyük Veri”nin önemini vurgulayan biriydim. Ancak yıllar içinde yaptığım gözlemler ve analizler, çoğu şirketin ve projenin aslında “Büyük Veri” ile uğraşmak zorunda olmadığını gösterdi.
-
Büyük Veri Tehdidi Abartıldı: Veri boyutları artsa da donanım kapasitesi daha hızlı arttı. Çoğu kuruluşun veri ambarları bir terabayttan küçük.
-
Gerçek İş Yükü Küçük: Sorguların büyük çoğunluğu çok küçük miktarda veri işliyor (örneğin %90’ı 100 MB’tan az). Devasa tablolar bile genellikle yalnızca küçük bir kısmı (son gün/ay) için sorgulanıyor.
-
Tek Makineler Güçlendi: Modern tek bir sunucu, birçok iş yükünü rahatlıkla çalıştırabilecek kapasiteye sahip. Dağıtık sistemlere her zaman gerek yok.
-
Veri Bir Yük: Eski verileri saklamak depolama maliyetinin yanı sıra yasal risk (GDPR, davalar) ve karmaşıklık (“bit rot”, unutulmuş veri anlamları) getiriyor.
-
Odak Noktası Değişmeli: Artık “veri ne kadar büyük” sorusundan ziyade “veriyi en iyi nasıl kullanır ve anlamlandırırız” sorusuna odaklanmanın zamanı geldi.